C01 Węzeł linii C
Wpływ crawl budgetu na pozycjonowanie stron – jak skutecznie zarządzać zasobami skanowania
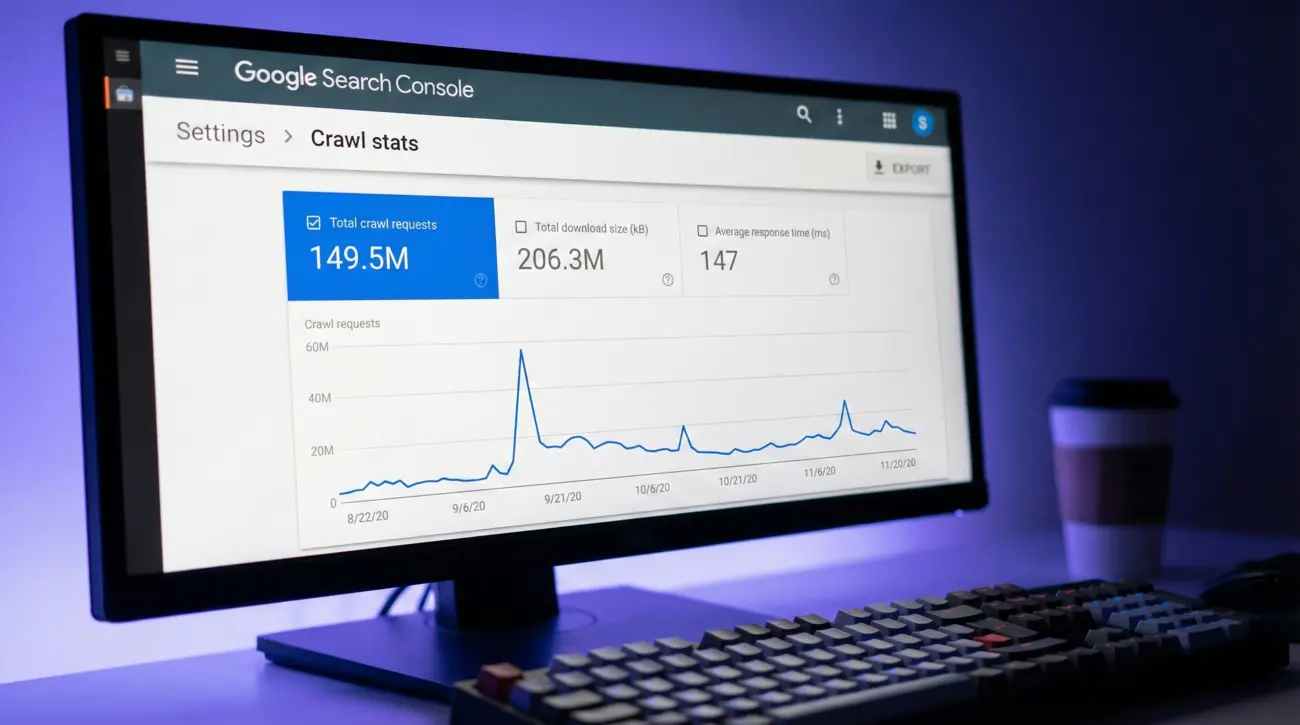
Crawl budget to liczba adresów URL, które Googlebot może i chce pobrać z Twojej witryny w danym czasie. Składają się na niego dwa elementy: limit wydajności skanowania (crawl capacity limit), czyli ile żądań serwer wytrzyma, oraz popyt na skanowanie (crawl demand), czyli ile adresów Google uważa za warte odwiedzenia. Według dokumentacji Google temat dotyczy głównie bardzo dużych serwisów (od około miliona stron o umiarkowanej częstotliwości zmian) albo serwisów z co najmniej 10 tysiącami stron zmieniających się bardzo często, oraz witryn z dużą liczbą adresów o statusie „Wykryto – obecnie nie zindeksowano”. Jeśli Twoje nowe strony są indeksowane w ciągu kilku dni, crawl budget nie jest Twoim problemem.
Znaczenie mapy strony XML – precyzyjna nawigacja dla robotów
Mapa strony XML to lista adresów, które chcesz mieć zindeksowane. Pomaga robotom znaleźć nowe i zmienione strony, ale Google traktuje ją jako wskazówkę, a nie polecenie – sam decyduje, które adresy odwiedzi i w jakiej kolejności. Mapa nie wyklucza więc adresów ze skanowania: do tego służą robots.txt, noindex i poprawna architektura linków. Więcej o samym pojęciu crawl budget znajdziesz poza tym artykułem, a podstawy skanowania w poradniku o SEO.
Jak mapa strony wspiera crawl budget i priorytetyzację
Umieszczaj w mapie tylko adresy kanoniczne, zwracające kod 200 i przeznaczone do indeksu. Mapa z przekierowaniami, błędami 404 i stronami z noindex marnuje czas robota i obniża jej wiarygodność.
Google używa znacznika lastmod, ale tylko wtedy, gdy daty są rzetelne, czyli zmieniają się przy istotnej zmianie treści (nie przy każdym wygenerowaniu pliku). Znaczniki priority i changefreq Google ignoruje. Rzetelny lastmod pomaga ponownie odwiedzać strony, które się zmieniły, a pominąć te, które nie.
Unikanie marnowania zasobów – pułapki techniczne
Największe źródło strat to adresy, które nie wnoszą nic do indeksu. Według Google są to przede wszystkim:
- nawigacja fasetowa i identyfikatory sesji – filtry kolorów, rozmiarów i cen mogą wygenerować tysiące adresów dla jednego produktu (tzw. nieskończone przestrzenie),
- zduplikowane treści (np. http/https, www/bez www, parametry śledzące),
- strony soft 404 – zwracające kod 200, ale wyświetlające komunikat o błędzie lub pustą treść; robot musi je pobrać i przeanalizować,
- długie łańcuchy przekierowań – każdy kolejny krok to dodatkowe żądanie,
- strony niskiej jakości i spam.
Standardowe błędy 404 i 410 nie marnują budżetu: Google traktuje wszystkie kody 4xx (poza 429) podobnie, jako informację, że treści nie ma. Nie zmieniaj więc masowo 404 na 410 w nadziei na oszczędność.
Praktyczne wdrożenia i analiza logów
Mapa powinna leżeć pod stałym adresem, zwracać kod 200, nie być zablokowana w robots.txt i być zgłoszona w Google Search Console. W dużych serwisach podziel ją na mniejsze pliki (maksymalnie 50 000 adresów lub 50 MB na plik) według typu treści, np. produkty, kategorie, artykuły. Dzięki temu w raporcie „Strony” sprawdzisz stan indeksowania osobno dla każdej mapy.
Sprawdź w GSC raport „Strony” (czy kluczowe adresy są zindeksowane) i raport „Statystyki indeksowania” w Ustawieniach (liczba żądań, czas odpowiedzi, błędy hosta). Dla małego bloga oczekuj prawie 100% zindeksowania adresów z mapy, a dla sklepu z dużą liczbą filtrów część adresów będzie wykluczona celowo. Najdokładniejsze dane o zachowaniu Googlebota dają logi serwera (log file analysis): pokazują, które adresy robot odwiedza, jak często i z jakim kodem odpowiedzi. Pozwalają też znaleźć sekcje marnujące budżet oraz strony osierocone, do których nie prowadzą linki wewnętrzne.
Optymalizacja crawl budgetu w e-commerce – walka o indeksację produktów
W sklepach główne źródło problemów to filtry i sortowanie. Google opisuje w dokumentacji o nawigacji fasetowej kilka rozwiązań: blokowanie adresów filtrów w robots.txt, stosowanie fragmentów adresu (#) zamiast parametrów w zapytaniu oraz linkowanie tylko do tych kombinacji filtrów, które mają sens jako osobne strony (np. marka + kategoria). Tag canonical na wariantach filtrów wskazujący kategorię pomaga w konsolidacji sygnałów, ale nie oszczędza budżetu, bo robot nadal musi pobrać stronę, żeby go zobaczyć.
Produkty trwale wycofane zwracaj z kodem 404 lub 410 (dla Google oba oznaczają to samo) albo przekierowuj 301 na bliski zamiennik, jeśli istnieje. Produkty tymczasowo niedostępne zostaw z kodem 200 i informacją dla użytkownika, żeby nie tracić pozycji.
Wpływ renderowania i JavaScript na zużycie budżetu
Strony oparte na JavaScript wymagają od Google dodatkowego etapu renderowania, który zużywa więcej zasobów niż prosty HTML. Poniższa tabela porównuje metody renderowania.
| Metoda renderowania | Zużycie zasobów (Crawl Budget) | Zastosowanie w SEO |
|---|---|---|
| Client-Side Rendering (CSR) | Wysokie – robot musi wykonać JavaScript, żeby zobaczyć treść. | Ryzykowne dla dużych serwisów; może opóźniać indeksację. |
| Server-Side Rendering (SSR) | Niskie – robot otrzymuje gotowy HTML. | Dobry wybór dla sklepów, serwisów newsowych i dużych witryn. |
| Static Site Generation (SSG) | Minimalne – gotowy HTML generowany na etapie budowy. | Idealne dla blogów, dokumentacji i treści rzadko zmienianych. |
| Hydration (SSR/SSG + JS) | Niskie – statyczny HTML wzbogacany interaktywnością po stronie klienta. | Kompromis łączący szybkość indeksacji z dynamiczną funkcjonalnością. |
Google opisuje technikę dynamic rendering (osobny, wyrenderowany HTML dla robotów i JS dla użytkowników) jako rozwiązanie tymczasowe, a nie długoterminowe, i zaleca zamiast niej SSR, statyczne renderowanie lub hydrację. Jeśli korzystasz jeszcze z dynamic renderingu, nie musisz migrować od razu, ale zaplanuj to przy najbliższej przebudowie serwisu.
Dodatkowe aspekty optymalizacji technicznej
Limit wydajności skanowania zależy od kondycji serwera. Gdy serwer odpowiada szybko i stabilnie, Google może zwiększyć liczbę żądań. Gdy zwraca błędy 5xx lub przekracza limity czasu, robot zmniejsza częstotliwość odwiedzin. Dokumentacja Google o szybkości odpowiedzi serwera zaleca czas poniżej 200 ms (Time To First Byte).
Googlebot obsługuje HTTP/2 w skanowaniu, co może zmniejszyć obciążenie serwera, ale nie wpływa na pozycje. Nie skanuje natomiast przez HTTP/3. Poza tym zadbaj o to, by serwer poprawnie obsługiwał nagłówki If-Modified-Since i zwracał kod 304 dla niezmienionych stron – robot nie pobiera wtedy treści ponownie.
Zarządzanie crawl budgetem w serwisach informacyjnych – wyścig z czasem
W portalach newsowych liczy się szybkość: nowy artykuł powinien trafić do indeksu możliwie szybko. Co pomaga:
- płaska architektura i linki do najnowszych artykułów z strony głównej i działów, tak by robot docierał do nich w kilku krokach,
- ograniczenie niskowartościowych adresów, takich jak archiwa kalendarzowe, tysiące stron tagów (np.
tag/nazwa) czy parametry w adresach, - osobna mapa dla wiadomości, na bieżąco uzupełniana, z rzetelnym
lastmod(lub mapa Google News dla serwisów w Google News), - wydajny serwer – nadmierny ruch botów (scraperów, botów AI) może obciążać infrastrukturę i pośrednio ograniczać skanowanie.
Uwaga: Google wycofał z końcem 2023 roku zgłaszanie map przez ping, więc nie opieraj na nim strategii; mapę zgłaszaj w Google Search Console i w robots.txt. Indexing API jest oficjalnie przeznaczone tylko dla stron z danymi strukturalnymi JobPosting i BroadcastEvent. Używanie go dla zwykłych artykułów jest niezgodne z zaleceniami Google.
Rola crawl budgetu w szybszej indeksacji stron internetowych
Popyt na skanowanie zależy według Google od trzech czynników: postrzeganej wielkości zasobów witryny (perceived inventory) – Google dąży do przeskanowania wszystkich znanych adresów, więc duplikaty i zbędne adresy zwiększają ten zasób na próżno; popularności adresów (adresy popularne w sieci, m.in. z licznymi linkami, są skanowane częściej) oraz nieaktualności (staleness) – im dłużej strona nie była odwiedzana, tym większa potrzeba jej ponownego skanowania. Nagłe zmiany, np. migracja serwisu, mogą też krótkotrwale zwiększyć popyt.
Jeśli nowe strony pojawiają się w indeksie w dniu publikacji, nie musisz nic optymalizować. Jeśli tygodniami wiszą w statusie „Wykryto – obecnie nie zindeksowano”, sprawdź w tej kolejności: szybkość i błędy serwera, liczbę zbędnych adresów, jakość i unikalność treści oraz linkowanie wewnętrzne do nowych stron. Zwiększenia limitu nie da się „zamówić” u Google, można tylko wyeliminować powody, dla których robot ogranicza skanowanie. Więcej o statusach przeczytasz w artykule o statystykach indeksowania w Google Search Console.
Wpływ crawl budgetu na pozycjonowanie stron – najczęściej zadawane pytania
Czym jest crawl budget w pozycjonowaniu stron?
To liczba adresów URL, które Googlebot może i chce pobrać z witryny w danym czasie. Zależy od wydajności serwera (crawl capacity limit) i od popytu na skanowanie (crawl demand).
Jak crawl budget wpływa na widoczność w Google?
Nie jest czynnikiem rankingowym, ale wpływa na to, jak szybko i jak kompletnie strony trafią do indeksu. Strona, której Google nie zeskanuje, nie pojawi się w wynikach wyszukiwania. Problem dotyczy głównie bardzo dużych serwisów.
Które błędy na stronie marnują crawl budget?
Nawigacja fasetowa generująca tysiące adresów, zduplikowane treści, strony soft 404, długie łańcuchy przekierowań oraz wolny serwer i błędy 5xx. Zwykłe błędy 404 i 410 budżetu nie marnują.
Jak sprawdzić wykorzystanie crawl budgetu w witrynie?
W Google Search Console otwórz Ustawienia → Statystyki indeksowania, gdzie zobaczysz liczbę żądań, czas odpowiedzi i błędy. Pełny obraz dają logi serwera, które można analizować narzędziami takimi jak Screaming Frog Log File Analyser, Oncrawl czy JetOctopus.
Czy szybkość serwera ma wpływ na crawl budget?
Tak. Szybki, stabilny serwer pozwala Googlebotowi pobierać więcej adresów, a błędy 5xx i przekroczenia czasu powodują, że robot zmniejsza liczbę żądań.
Czy standardowe błędy 404 marnują crawl budget?
Nie. Strony zwracające kody 4xx (poza 429) nie marnują budżetu, bo robot szybko otrzymuje informację, że treści nie ma. Problemem są soft 404, czyli strony z kodem 200 i komunikatem o błędzie.
Cała linia: Crawlowanie i indeksacja
- C01węzełjesteś tutaj
Crawl budget
- C02
Indeksacja w GSC
- C03
Tag noindex
Przesiadki
Węzły pozostałych linii – od nich zaczyna się każdy dział Akademii.
- Co to jest SEO? Kompleksowy przewodnik po optymalizacji w 2026 rokuPodstawy SEO
- Jak skutecznie wyszukiwać słowa kluczoweSłowa kluczowe
- Przewodnik po kodach statusu HTTP: jak interpretować odpowiedzi serweraTechniczne SEO
- Topical authority w SEO – jak stać się autorytetem w swojej niszy?Semantyczne SEO
- Nawigacja fasetowa – jak optymalizować ją dla SEO?SEO dla e-commerce
- Jak algorytm Panda zmienił zasady gry w SEO?Algorytmy Google
- Analiza danych w Google Search Console i ich wpływ na ruch internetowyNarzędzia SEO